


项目简介
TopicPicker(选题体检) 是一个给内容创作者用的选题决策 skill:把你自己从创作者后台导出的作品数据喂给它,
它先反推出「你的」选题公式,再拿这套公式给待选选题打分、排序,并把会撞车的那些直接拦下来。
整个 skill 就两个 markdown 文件,纯文本、零依赖、不用配置,丢进 AI 编程工具的 skills 目录就能用。
它的核心思路和常见的「盯热点」工具完全相反:热点只告诉你别人在做什么,你自己的数据才告诉你你做什么会成。
同一个账号里,成的作品一定共享某种结构,扑的作品也一定共享某种结构——TopicPicker 做的事就是把这两种结构挖出来,
写成一句能直接套用的公式(主词 + 具象动作 + 数字),再用它当尺子去量每一个新想法。
找新题时它只用 GitHub 等公开开源社区,按一周涨星速度排序,并逐个核实项目文档里是否真的支持你要讲的工具。
它以 agent skill 的形式工作,Codex、Cursor、Claude Code 等支持 skill 的工具通用:装好之后打个 @ 就能调用。
最重要的是它敢说不——候选选题和你近期发过的内容核心动词相同,它会一票否决并给出历史证据,
帮你拦住那条大概率白做一周的视频。
📎 相关链接与下载地址(点击展开)
核心亮点
它能做什么、输出什么
| 项目 | 说明 |
|---|---|
| 输入 | 你自己从创作者后台导出的作品数据表(CSV/Excel,需含标题、发布时间、播放、点赞、评论、分享、收藏),外加你想评估的候选选题(可选) |
| 适用类型 | 任何持续更新的内容账号:短视频、图文、公众号均可,指标列能对上就行 |
| 输出 | 诊断报告(受众排序、你的标题公式、黑名单、重做池)+ 候选打分排序表(附预测收藏率区间)+ 撞车判定 |
| 语言 / 兼容 | 中文为主;Codex、Cursor、Claude Code 等支持 agent skill 的工具通用 |
| 规格 / 容量 | 样本 ≥20 条起效;>50 条可产出完整公式与黑名单;单分组不足 5 条时自动标注「结论待验证」 |
环境要求
| 环境 | 建议配置 |
|---|---|
| 操作系统 | Windows / macOS / Linux 均可,skill 是纯文本,跟系统无关 |
| 运行环境 | 任意一个支持 agent skill 的 AI 编程工具(Codex、Cursor、Claude Code 等) |
| 硬件 | 无要求,不跑本地模型、不占显存 |
| 低配 / 无卡方案 | 不存在这个问题——它只是两份给 AI 看的说明书 |
| 关键依赖 | 无。不装 Python 包、不装 Node 包、不需要密钥 |
如何使用
💡 整个流程 5 分钟:导出一份自己的数据 → 建目录 → 把两份 markdown 放进去 → 打
@开始用。全程不需要写一行代码。
进入你所在平台的创作者后台,在数据中心找到「作品数据」,导出近 3~6 个月的明细表(CSV 或 Excel),放到你的工作目录里。列里最好有:标题、发布时间、播放、点赞、评论、分享、收藏。
我的项目/
├── data/
│   └── 作品数据.csv        ← 后台导出的明细表放这里
└── ...在你用的 AI 编程工具的 skills 目录下新建一个文件夹。以 Cursor 为例是项目里的 .cursor/skills/,Codex、Claude Code 放各自的 skills 目录,结构完全一样。
mkdir -p .cursor/skills/topic-picker
# 目录里就放两个文件:
# topic-picker/
# ├── SKILL.md        主流程
# └── reference.md 判据和打分细则SKILL.md 定义五步工作流,下面是核心骨架,复制后可按自己账号情况微调;打分细则、诊断报告模板放 reference.md(按第 4 步的维度表自行展开即可)。不想手动复制的话,页首「相关链接与下载地址」折叠块里有两个文件的完整打包,下载解压即用。
---
name: topic-picker
description: 选题体检。读用户提供的作品数据表,反推该账号的
  选题公式,为候选选题打分排序,拦下会撞车的选题。
---

# 选题体检

数据源红线:只读用户本地提供的数据表和 GitHub 等公开
开源社区的项目页,不读取任何内容平台的站内数据。

## 工作流

1. **算派生指标**:收藏率=收藏/播放,分享率=分享/播放;
   按受众(如 程序员/创作者)和能力类型(新能力/老结果
   提升)给每条作品打标签分组。
2. **反推公式**:对比高播放组和低播放组的共性,产出
   「你的标题公式」(主词+具象动作+数字)和「你的黑名单」
   (连续扑过的题材类型)。
3. **出去找题**:没给候选时,顺着受众线去 GitHub 等公开
   社区找一周涨星快的新项目,逐个打开文档核实能力属实
   才入围。
4. **打分排序**:按维度表给每个候选打分,附预测收藏率
   区间和判分理由。
5. **撞车拦截**:候选与近 10 期作品核心动词相同 → 一票
   否决,给出历史那条的数据当证据。

## 输出要求

先给一页诊断报告(受众排序/公式/黑名单/重做池),
再给候选排序表。每个结论必须附数据出处,样本不足
5 条的分组标注「待验证」。打开对话框,输入 @ 选中 topic-picker,然后像跟同事说话一样提需求:
@topic-picker 读一下 data/作品数据.csv,告诉我我为什么能爆、为什么会扑
@topic-picker 这五个想法帮我排个序,说清楚为什么
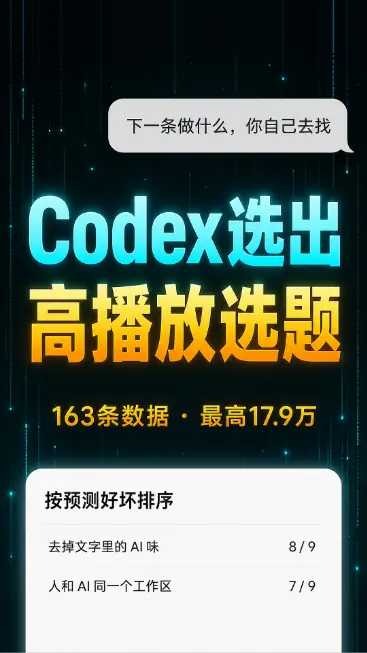
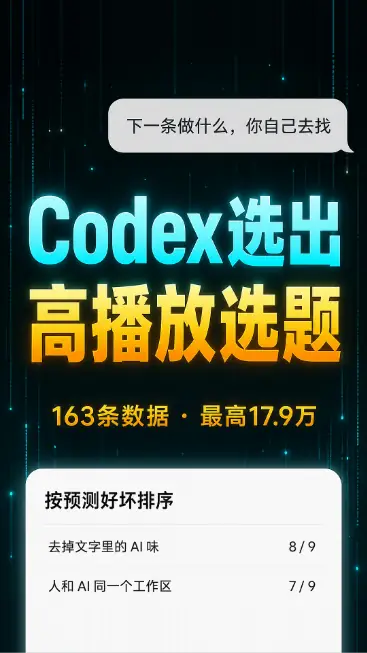
@topic-picker 下一条做什么,你自己去找
打分维度(reference.md 里展开):
| 维度 | 看什么 |
|---|---|
| 受众匹配 | 候选面向的人群是不是你数据里收藏率最高的那一类 |
| 能力类型 | 「以前做不到的新能力」历史上普遍强于「老结果再提升」 |
| 标题可套公式 | 能不能写成 主词 + 具象动作 + 数字 的结构 |
| 题材新鲜度 | 与近 10 期核心动词是否重复(重复=一票否决) |
| 热度趋势 | 开源项目看一周涨星速度,不看总星数 |
数据读过一次之后,它已经记住了你的受众和公式。这时候不给候选、直接让它找题,它会顺着你的受众线去开源社区翻一周涨星快的新项目,核实完文档再报给你一张排好序的表。
✅ 选题从「我觉得行」变成「数据说行」:每个入围的题都带判分理由和预测收藏率,会撞车的在你动手之前就被拦掉了。
典型应用场景
与常见做法对比
| 做法 | 差别在哪 |
|---|---|
| 盯热点榜单选题 | 热点反映的是别人的粉丝盘;同一个热点,别人做爆你做扑是常态。TopicPicker 的公式只从你自己的数据里来 |
| 直接问通用 AI「我做什么题好」 | 没有你的数据,它只能给通用套话。喂了数据再问,答案会从「大家都说好」变成「你的账号里这类题收藏率高 3 倍」 |
| 人工翻表复盘 | 能做,但很少有人坚持:163 条数据交叉对比受众、能力类型、标题结构,人工要一下午,skill 几分钟出报告 |
| 凭手感拍脑袋 | 最大的成本不是选错,而是撞车——同题材间隔太近,第二条几乎必扑,这是拿真数据验证过的规律 |
🧠 原理一句话:AI 早就会分析数据,缺的是「按什么标准分析」。skill 把标准写死成判据和红线,AI 每次都按同一把尺子量,结论才可复用、可累积。
常见问题
Q: 它和热点监控类工具有什么区别?
方向相反。热点工具回答「大家在看什么」,TopicPicker 回答「你做什么会成」。它不读任何内容平台的站内数据,信源只有两个:你自己导出的数据表,和 GitHub 等公开开源社区的项目页。
Q: 我的后台导不出收藏数怎么办?
没关系。收藏率是最好用的先行指标,但不是必需列。有播放、点赞、评论、分享四列就能跑,skill 会自动改用分享率和赞播比做替代指标,并在报告里注明口径。
Q: 我账号才发了十几条,样本够吗?
能跑但结论会打折。20 条以下 skill 只做单条复盘、不出整体公式;分组后单组不足 5 条的结论都会标「待验证」。发满 50 条再回头做一次全量体检,公式才稳。
Q: 图文/公众号账号能用吗?
能。它认的是指标列不是平台:把「播放」换成「阅读」、「收藏」换成「在看/收藏」,逻辑完全一致。多平台账号建议一个平台一张表分开喂,粉丝盘不同,公式也不同。
Q: 预测收藏率准吗?
它给的是区间不是保证,本质是「历史上同类题落在这个区间」。样本越多越准,而且每发一条新作品把数据补进表里,公式会跟着修正——这是个越用越准的循环。
Q: 为什么它不直接帮我把数据取回来?
刻意设计成只读你手动导出的文件。一是各平台对第三方读取站内数据有严格限制,碰了账号有风险;二是导出明细表本来就是后台自带功能,一分钟的事,不值得为省这一分钟冒险。
Q: 一票否决太严格了,能关掉吗?
可以在 SKILL.md 里把「近 10 期」改小,但不建议关。撞车是历史数据里最一致的扑量原因:同一个核心动词间隔太近,第二条的数据普遍只有第一条的零头。它拦你一次,可能就省下一周白干。
Q: 只能在 Codex 里用吗?
不是。agent skill 是通用格式,Codex、Cursor、Claude Code 都支持,放进各自的 skills 目录即可。甚至不支持 skill 的工具里,把两个 markdown 的内容直接粘进对话当指令,效果也有八成。
Q: 可以商用吗?
skill 本体是你自己目录里的两个 markdown 文件,内容随便改随便用。注意商用边界在数据侧:只分析你自己账号导出的数据没有问题,拿去分析别人的账号数据要先取得授权。
本站收集的资源仅供内部学习、研究软件设计思想与原理使用。学习研究后请自觉删除,请勿添加内容资料中的联系方式,谨防受骗;请勿传播。因未及时删除或用于其他用途所造成的任何后果,均由使用者自行承担。感谢理解与配合!
若您认为「cmzhiku.com」发布的内容侵犯了您的合法权益,请联系站长邮箱:ksxwdyx@qq.com。我们将在核实后及时进行删除处理。
本站资源大多存储于云盘。如发现下载链接失效或资源异常,请及时联系我们,我们会第一时间核实并更新。