


项目简介
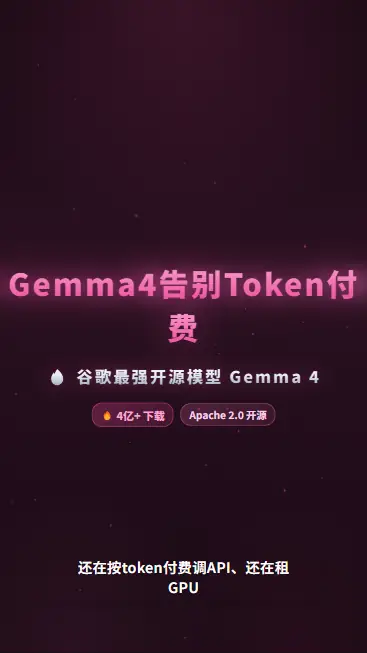
Gemma 4 是 Google DeepMind 基于 Gemini 3 研究和技术打造的最新开源模型家族,旨在最大化每参数智能表现。它提供 4 种规格(E2B、E4B、26B MoE、31B Dense),从手机到桌面设备全覆盖,支持 140+ 语言和多模态(文本/图片/视频/音频),采用 Apache 2.0 开源协议。
💡
官方页面:
https://deepmind.google/models/gemma/gemma-4/
Google AI Studio:
在线试用 Gemma 4 31B
核心亮点
如何使用
方式一:通过 Google AI Studio 在线试用
在模型选择器中选择 gemma-4-31b-it(31B)或 gemma-4-26b-it(26B MoE),即可开始对话。
方式二:通过 Ollama 本地部署
打开终端,运行以下命令即可开始对话:
# 运行 26B MoE(推荐,速度快)
ollama run gemma4:26b

# 运行 31B Dense(质量最高)
ollama run gemma4:31b

# 运行 E4B(轻量级,适合低配设备)
ollama run gemma4:e4b模型下载完成后自动启动交互式对话,支持中文、英文等 140+ 语言。也可通过 API 方式调用:http://localhost:11434/api/chat
方式三:通过 Hugging Face 下载权重
常见问题
Q: Gemma 4 的四个模型怎么选?
E2B:手机/IoT 设备,离线运行;E4B:手机/平板,更强推理;26B MoE:笔记本/台式机,3.8B 激活参数极速推理(推荐);31B Dense:台式机/服务器,输出质量最高。
Q: 需要什么硬件配置?
E2B/E4B 可在手机上直接运行;26B MoE 推荐 16GB+ 内存/显存;31B Dense 推荐 24GB+ 显存或使用量化版本(如 Q4_K_M)在 16GB 显卡上运行。
Q: 可以商用吗?
可以!Gemma 4 采用 Apache 2.0 开源协议,允许个人和商业用途,无需付费。
Q: 支持哪些语言?
原生支持 140+ 语言,包括中文、英文、日文、韩文、西班牙语、法语等主流语言,能理解文化语境而非简单翻译。
本站收集的资源仅供内部学习、研究软件设计思想与原理使用。学习研究后请自觉删除,请勿添加内容资料中的联系方式,谨防受骗;请勿传播。因未及时删除或用于其他用途所造成的任何后果,均由使用者自行承担。感谢理解与配合!
若您认为「cmzhiku.com」发布的内容侵犯了您的合法权益,请联系站长邮箱:ksxwdyx@qq.com。我们将在核实后及时进行删除处理。
本站资源大多存储于云盘。如发现下载链接失效或资源异常,请及时联系我们,我们会第一时间核实并更新。